先从一个直观的问题说起
很多人第一次接触磁力链接,都会觉得它很「反常识」:就一串看起来没什么规律的字符,凭什么点一下,客户端就能找到分散在世界各地的下载来源,最终把完整的种子资源拼凑出来?这个问题的答案,恰恰是 BT 协议家族最精巧的部分——它把「我在哪能拿到资源」这件事,从依赖某台中心服务器,变成了全网协作、人人皆可参与索引的分布式机制。
Tracker:集中式索引的开端
最早的 BT 网络,依赖一个叫 Tracker(追踪服务器)的角色。你可以把它理解成一个「签到簿」:每个下载者上线后,都会向 Tracker 报告自己的 IP 和端口,同时问一句「还有谁在下同一个文件」。Tracker 汇总这些信息,再把你需要的同伴列表发回给你。这个设计简单直观,但有一个致命弱点——Tracker 本身是单点。一旦 Tracker 服务器被关停、宕机,或者被墙,整个下载网络就瞬间「失联」,用户手里的磁力链接也就成了一串死数据。
更麻烦的是,Tracker 还需要维护和管理成本。对大量免费的公共 Tracker 而言,这注定是不可持续的。于是,工程师们开始思考一个方向:能不能不要这个「中心」,让参与者自己互相传递信息?
DHT:把索引「分发」给每个人
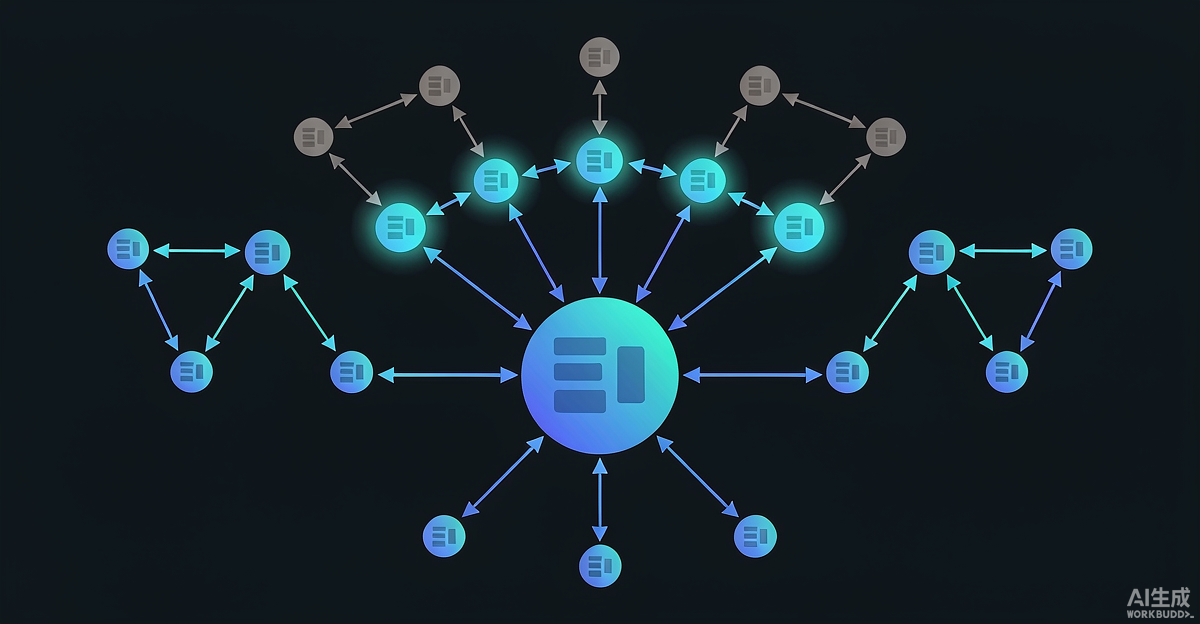
答案就是 DHT,全称分布式哈希表(Distributed Hash Table)。BT 采用的具体实现叫 Kademlia。它的核心思想非常朴素:既然每个节点都有一小块「附近」的索引信息,那么只要所有节点都管好自己那一小片,全网合起来就构成了一张覆盖所有资源的、没有中心的索引大网。
在 Kademlia 里,每个节点都有一个随机的 ID,每个资源(磁力链接里的 info_hash)也被映射到同样的 ID 空间。节点之间通过「异或距离」来衡量远近,谁离某个资源 ID 最近,谁就负责记录「谁有这份资源」的信息。当你想下载某个文件时,客户端会像接力问路一样,先问几个已知的「引导节点」,再一步步逼近真正掌握该资源同伴列表的那些节点。整个过程不依赖任何一台中心服务器,即便某个节点掉线,其余节点照样能补位,这正是 bt磁力 网络「打不死」的底层原因。
磁力搜索引擎:帮你找到「入口」
理解了 DHT,就很好理解磁力搜索引擎的定位了。磁力链接本身并不携带文件名、体积、文件清单这些信息,它只有一个哈希值。磁力搜索引擎做的事,是把全网散布的、已经被人抓取到的元数据(文件名、大小、做种数等)汇总起来,做成可检索的数据库,让你能用关键词找到对应的磁力链接。
需要特别说明的是,这类索引服务的角色更像「图书馆的目录卡片」——它记录「有这么一本书、放在哪个书架」,但书的内容是否合法,取决于内容本身,而非目录。这也带来一个重要的合规边界:一个负责任的搜索或下载行为,应当始终把落脚点放在合法内容上,而不是用它去获取未经授权的盗版影视或软件。
元数据交换:拿到哈希之后的事
当你通过磁力搜索引擎找到一串磁力链接,客户端拿到 info_hash 后,还要做一件事:从 DHT 网络中「打听」这份资源的元数据(文件名、目录结构、分块大小等)。这个动作靠的是 BEP 9 定义的 ut_metadata 扩展,客户端向同伴逐块请求元数据,拼装完整后还会重新计算哈希校验一遍,确认没有被篡改。拿到元数据,才能真正开始分块下载。
从这里也能看出一个有趣的细节:磁力链接之所以能「自我修复」,是因为它把「找同伴」和「找信息」这两件事,都托付给了分布式的 DHT 网络,而不是某一家服务器。这种去中心化的韧性,正是它被广泛讨论的原因。
合法用途:分布式索引的正道
技术本身是中立的,磁力链接和 DHT 最大的价值,恰恰体现在合法场景里。最典型的例子是各大 Linux 发行版:Ubuntu、Debian、Fedora 等官方镜像都会同时提供 .torrent 与磁力链接,让全球用户在版本发布的高峰期,靠 P2P 分流服务器压力,既快又省带宽。此外,许多机构开放数据集、公有领域内容也通过这种方式分发。
所以,如果你对磁力下载感兴趣,最稳妥、也最值得推荐的做法,是从官方开源镜像站、项目官网这类正版渠道获取种子资源,既体验了分布式网络的技术魅力,又完全不必担心版权风险。
小结
磁力搜索之所以高效,是因为它站在一套从 Tracker 演进到 DHT 的分布式索引体系之上:哈希作为资源「身份证」,DHT 负责无中心的寻址,搜索引擎负责汇总入口,元数据交换负责补齐信息。理解了这条链路,你就能明白磁力链接不是「黑魔法」,而是一套严谨、开放、可验证的 P2P 协作协议。技术本身无善恶,关键在于我们把它用在合法、正当的地方。
© 版权声明
文章版权归作者所有,未经允许请勿转载。