一个「动荡却稳定」的矛盾
任何接触过 bt磁力 的人都会发现一个有趣的现象:P2P 网络里没有任何中心服务器,每个参与者都可能随时关机、断网、退出,节点像潮水一样来了又走,但磁力搜索和下载却几乎不受影响。这种「动荡中的稳定」是怎么做到的?答案藏在 DHT(分布式哈希表)的路由表维护机制里。理解它,也就理解了磁力链接这种去中心化技术为何如此抗打击。
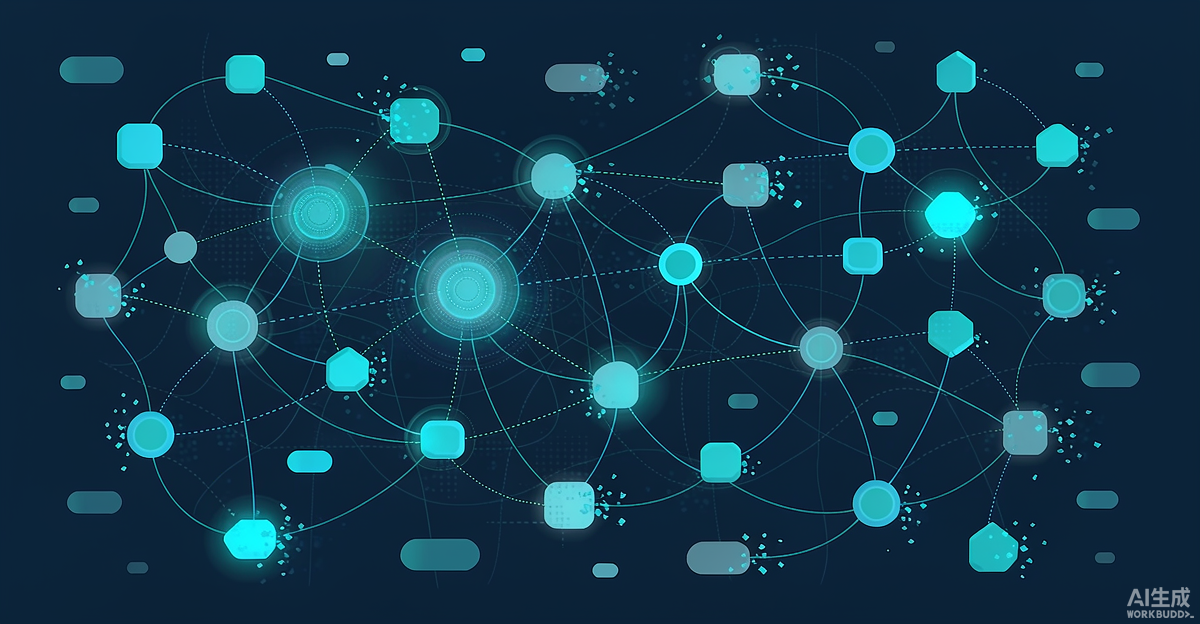
要说明这一点,得先回到磁力链接的核心:它只携带一个信息哈希,并不包含「从哪里下载」的地址。真正负责把哈希「翻译」成可连接节点列表的,是分布在无数客户端里的路由表。每个客户端都维护着一张记录其他节点地址的表格,通过互相问路,最终定位到拥有目标内容的同伴。这张路由表如何在高频的节点波动中保持有效,正是本文要聊的重点。
Kademlia 路由表长什么样
DHT 最主流的实现是 Kademlia 算法。它的路由表把整个「节点空间」划分成一个个桶(bucket),每个桶负责一段特定范围的节点 ID。节点 ID 通常是 160 位的随机标识,越「靠近」自己的节点,路由表里记录得越详细。判断「远近」用的是异或(XOR)距离,而不是地理距离,这是一种纯数学的度量,用来衡量两个 ID 之间的相似程度。
当一个客户端需要查找某个哈希对应的节点时,它会先从自己的路由表里挑出距离目标最近的若干节点,向它们发出查询;对方返回「我更靠近目标的邻居是谁」,客户端再继续向更近的节点问路。这种「一步步逼近」的迭代式查找,让一次定位只需跳跃十几次就能完成,即使全网有数百万节点也游刃有余。磁力搜索引擎之所以能快速响应,背后正是这套高效寻址在支撑。
节点波动(Churn)与表维护
路由表面临的最大挑战,是「节点波动」,也就是节点频繁加入和离开网络的现象。一个节点可能因为关机、断网、程序崩溃而突然消失,如果没有应对机制,路由表很快就会被大量「死地址」填满,查找效率随之崩塌。为此,Kademlia 设计了多种维护手段。
其一是定期探测,客户端会周期性向桶里的节点发送轻量查询,确认对方是否仍在线,长时间无回应的条目会被移出并替换为活跃的新节点。其二是新节点替换旧节点的「竞争上岗」,当桶已满又收到新节点时,系统会优先淘汰那些已经失联的旧条目。其三是利用日常查询本身来刷新路由表——每一次下载、每一次磁力搜索,都会顺带更新沿途接触到的节点状态,让表格始终「活」着。这套自我维护机制,正是去中心化网络在缺乏管理员的情况下仍能长期健康运转的关键。
为什么这样设计更「抗造」
对比中心化的索引服务,DHT 路由表的优势一目了然:没有单点故障,不存在「服务器一宕机全网瘫痪」的软肋。即便某个区域的节点大规模离线,其余节点仍能通过各自的路由表继续互连、继续定位。这也是为什么很多开源软件项目选择用 bt磁力 作为镜像分发手段——它把「抗打击」这件事内建在了协议设计里。
当然,去中心化也意味着责任分散。没有中心服务器,也就没有人替你审核内容,用户需要自己判断种子资源是否合规、是否可信。磁力搜索、磁力搜索引擎只是「问路」的工具,真正决定合法边界的,是内容本身的授权状态。把这个边界想清楚,才能既享受去中心化的稳健,又不越合规红线。
从机制到合法应用
理解了路由表的自我维护,就能更理性地看待磁力链接的价值。它最适合的场景,是那些体积大、受众广、且完全开放授权的合法内容:Linux 发行版的系统镜像、公有领域的电子书库、机构公开发布的数据集。这类内容通过 DHT 网络分发,既减轻了单一服务器的带宽压力,又天然获得了去中心化带来的高可用性。
对普通用户而言,最务实的做法是:把 DHT 的稳健用在正道上,下载开源软件或公有领域资料时,可以放心使用磁力链接;而面对来源不明的资源,则始终以官方正版渠道为先。技术是中性的,让它在合法、透明的场景里发挥价值,才是对它最好的使用方式。
小结
DHT 路由表通过分桶存储、迭代寻址、定期探测与竞争替换,在高频的节点波动中维持了磁力搜索的稳定与高效。这套自我维护机制让磁力链接无惧单点故障,也提醒我们:工具本身可靠,使用它的边界才需我们主动守护。
© 版权声明
文章版权归作者所有,未经允许请勿转载。