从一次「下载中断」说起
如果你用过磁力链接下载大文件,多半经历过这样的场景:进度条走到 80%,网络突然断了一下,客户端却没有从头再来,而是从断点接着下。这种「断点续传」的能力,正是 BT 协议与磁力搜索生态里最基础也最实用的特性之一。要理解它,我们得先弄清楚:一个文件在被分享时,到底发生了什么。
传统下载通常是从单一服务器拉取完整文件,一旦连接中断,往往需要重开请求。而 BT 下载从设计之初就换了一种思路——把大文件切成一个个固定大小的数据分块(piece),每个分块都用哈希算法算出独一无二的指纹。磁力链接里那串长长的哈希值,本质上就是这份「分块账本」的摘要,它不指向某个具体地址,而是指向「内容本身」。这也是为什么磁力搜索能够绕过中心服务器、直接依据内容寻址。
分块与校验:断点续传的地基
当客户端解析一个磁力链接时,它首先会通过 DHT 网络或 Tracker 找到持有同一份资源的其他节点,再获取一份描述文件结构的元数据。元数据里记录了每个分块的大小、顺序和校验哈希。下载过程中,客户端可以同时从多个节点拉取不同的分块,这就是「多源并行」——也是 bt磁力下载速度能随做种人数上升的关键原因。
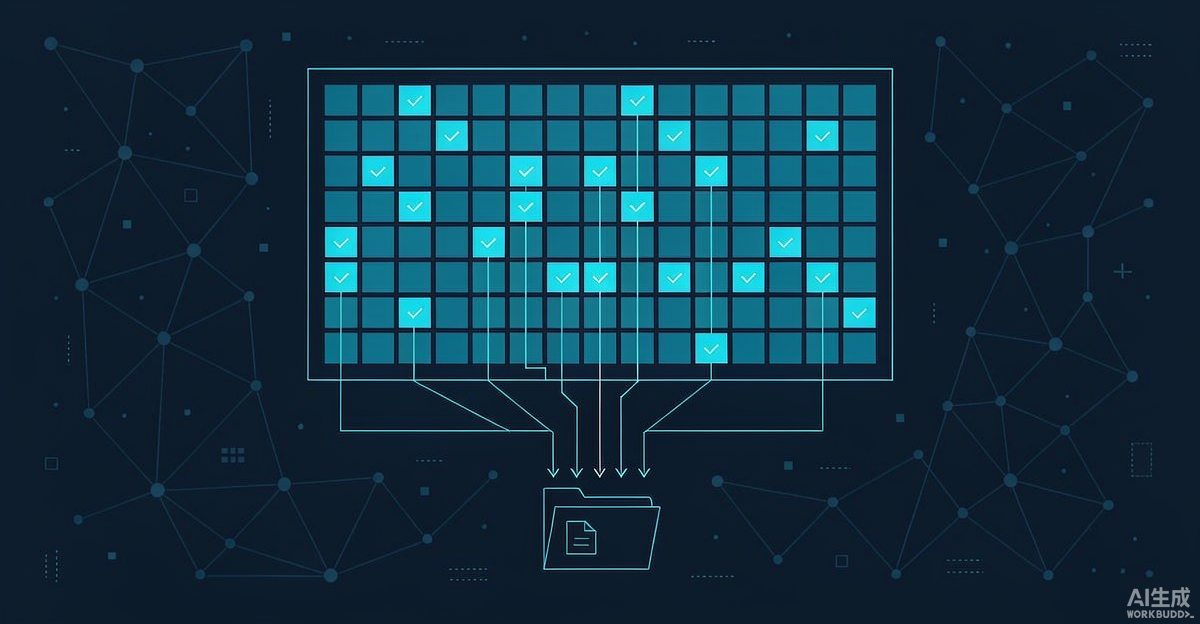
每下载完一个分块,客户端会立即计算它的哈希,与元数据比对。校验通过,这个分块就被标记为「已完成」;校验失败则丢弃重下。正因如此,断点续传才成为可能:程序记住的是「哪些分块已经通过校验」,而不是「下载到了哪个百分比」。下次连接恢复,它只需要补齐尚未完成的分块,再按顺序拼接即可。这种机制还顺带解决了文件完整性问题——任何被篡改或传输损坏的分块,都会在哈希校验这一关被拦下。
磁力搜索引擎在其中扮演什么角色
很多人会把「磁力搜索引擎」误解成一个存放文件的服务器,其实它更像一个「索引黄页」。它索引的并非文件本体,而是磁力链接、文件名、文件大小、做种数等描述性信息。你通过关键词搜到的,是这些元数据的匹配结果;真正的数据传输,仍然发生在下载者与做种者之间,点对点完成。理解了这一点,也就明白为什么有的磁力链接「能搜到却下不动」——因为当前没有足够的节点在线做种,而非搜索引擎故障。
断点续传的边界与注意事项
断点续传虽然便利,但并非万能。如果原始资源的元数据本身不完整、分块校验信息缺失,客户端就无法校验,续传也就无从谈起;如果做种者整体下线,即便你只差一个分块,也只能等待有人重新上线。此外,某些配置下客户端会因临时文件路径变化、磁盘空间不足而丢失已完成的进度,因此建议固定下载目录、预留充足空间。
从合规角度看,断点续传这套技术是中性的,关键在于「下载什么」。合法的种子资源同样大量存在:Linux 发行版的官方镜像、开源软件的安装包、公有领域的图书与数据集,很多都主动提供磁力链接以节省带宽、提升分发效率。养成从官方渠道获取种子的习惯,既能享受 P2P 的高效,也能远离版权与安全风险。
小结
磁力链接之所以支持断点续传,靠的是「分块 + 哈希校验 + 多源并行」这套组合拳。它让下载从「依赖单点」走向「内容寻址」,也让中断不再意味着从头再来。理解这套机制后,再使用磁力搜索、bt磁力等工具时,你会更清楚每一步在发生什么,也更懂得如何安全、合法地利用它。
© 版权声明
文章版权归作者所有,未经允许请勿转载。