从一串字符说起:磁力链接到底指向了什么
接触过 BT 下载的人,多半对磁力链接并不陌生。它不像传统的下载链接那样指向某个具体服务器上的文件,而是一串以 magnet:? 开头的标识符,核心是一段经过哈希算法计算出来的”指纹”。理解这一点,是理解磁力下载一切后续行为的前提:你拿到手的并不是文件本身,也不是某个存储文件的位置,而是一个能够唯一定位”这份内容”的数字摘要。
这正是磁力搜索与磁力搜索引擎存在的技术基础。所谓磁力搜索,本质上就是在海量节点之间,根据这段指纹去寻址”谁拥有这份内容”。它绕开了中心服务器,把查找动作分散到每一个正在参与分享的节点上。因此,磁力链接天生就适合那些不需要永久固定服务器的分发场景,比如开源软件、Linux 发行版镜像,以及大量进入公有领域的资料。
分块:为什么中断下载还能接着下
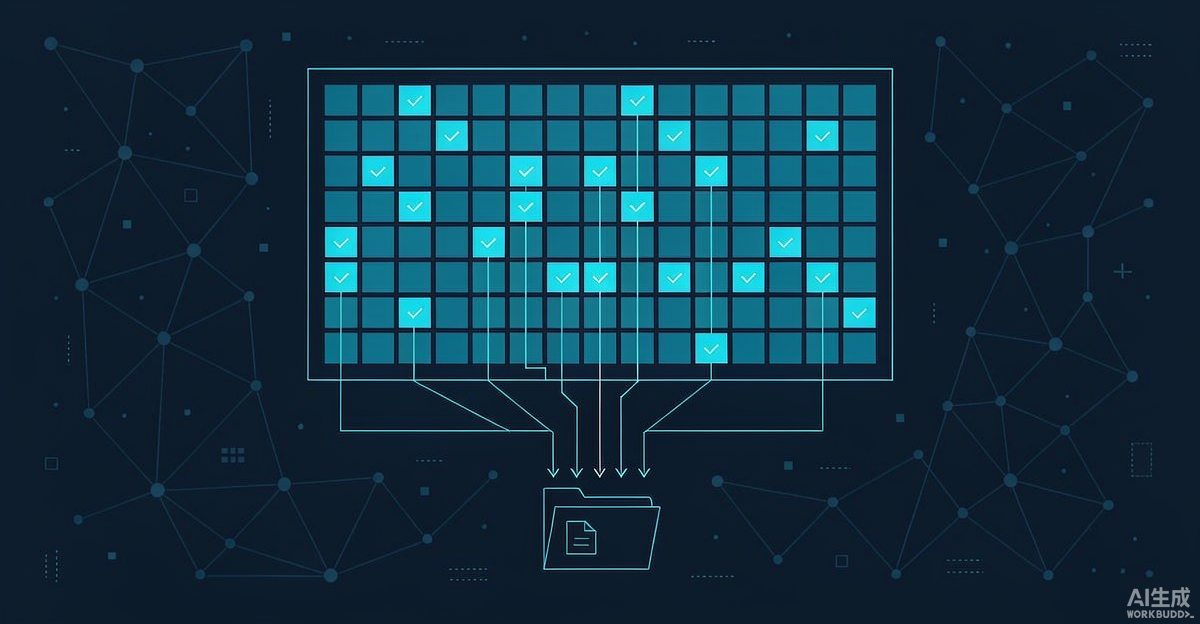
BT 协议最巧妙的设计之一,是它从不把文件当作一个整体来传输,而是先把它切成一个个固定大小的”分块”。每个分块都有独立的编号和独立的哈希校验值。当你通过磁力链接开始下载时,客户端会同时向多个拥有该内容的节点请求不同的分块,谁有哪一块,就从谁那里拿哪一块。
这种分块机制直接带来了两个结果。第一是多源并行:一个文件可以由成百上千个节点共同”凑”出来,速度不再受限于某一个上传者的带宽。第二就是断点续传——即便你中途关机、断网,客户端只需要记下”已经校验完成的分块清单”,下次启动时跳过这些分块,只补剩下的部分即可。对动辄几个 GB 的 Linux 系统镜像来说,这个特性意味着下载再也不用从头再来,这正是磁力链接区别于传统直链下载的重要优势。
哈希校验:如何保证下到的文件是”对的”
分块传输解决了效率和续传问题,但还留下一个隐患:如果某个节点传过来的分块被篡改、损坏,或者干脆是恶意内容,怎么办?答案同样藏在磁力链接的那段指纹里。文件的整体哈希值,以及每一个分块的哈希值,都写进了种子资源的元数据中。
客户端每下载完一个分块,就会立即用哈希算法重新计算一遍,再和元数据里的期望值比对。对不上,就丢弃这一块,换一个节点重新请求。只有当所有分块都逐块校验通过、最终拼合结果又与整体哈希一致时,下载才算完成。这套”内容寻址 + 逐块校验”的机制,让 BT 磁力下载具备了一种相当可贵的属性:你下到的文件可以被数学地证明就是发布者原本提供的那一份,中间没有被掉包。
这种可校验性,恰恰是很多大型开源项目愿意用种子资源分发镜像的原因。无论是 BT 还是衍生出来的 bt磁力下载方式,都继承了这套逐块校验的可靠性,因此才能在无中心服务器的情况下长期稳定运行。官方团队把镜像和对应的校验值一起公布,用户下载完成后可以独立验证文件的完整性,既省了中心服务器的带宽,又不牺牲安全性。
DHT 与节点发现:没有服务器,谁告诉你该找谁
早期 BT 依赖 Tracker 服务器来撮合下载者,但 Tracker 一旦宕机,整个分享网络就受影响。后来发展出的 DHT(分布式哈希表)技术,把”寻址”这件事彻底分散开来。每个节点只需要维护一张小型的路由表,通过层层跳转,就能在无需任何中心服务器的情况下找到拥有特定磁力链接内容的其它节点。
换句话说,磁力搜索引擎与传统搜索引擎的根本区别,在于前者索引的并非”网页内容”,而是分布式网络中节点的可达性与内容指纹。这也解释了为什么磁力搜索往往显得”不稳定”:它依赖的是一个动态变化的节点网络,而非恒定在线的数据库。理解这层区别,有助于你用更理性的眼光看待磁力链接这一技术工具的边界与能力。
小结
磁力链接之所以能实现断点续传、多源加速与完整性校验,靠的是分块、哈希与 DHT 这三大支柱的共同作用。它是一种中立的内容分发技术,在开源软件、系统镜像与公有领域内容的合法分发中发挥着不可替代的价值。作为使用者,我们应当把这些能力用在正版、开放的内容上,选择官方镜像与授权渠道,让技术回归它本来的用途。
© 版权声明
文章版权归作者所有,未经允许请勿转载。