一个看似矛盾的问题
不少人对 bt磁力 下载的第一印象是「没有中心服务器」。种子资源分散在无数用户电脑里,谁也没有完整的「名册」。可这就带来一个尴尬:既然没有中心,你装好客户端的那一刻,凭什么知道该联系谁?这台全新、谁也不认识的电脑,究竟是怎么第一次「找到组织」的?这个看似矛盾的过程,正是磁力链接体系里一个非常精巧的设计,也是今天想聊清楚的技术原理。
什么是引导节点
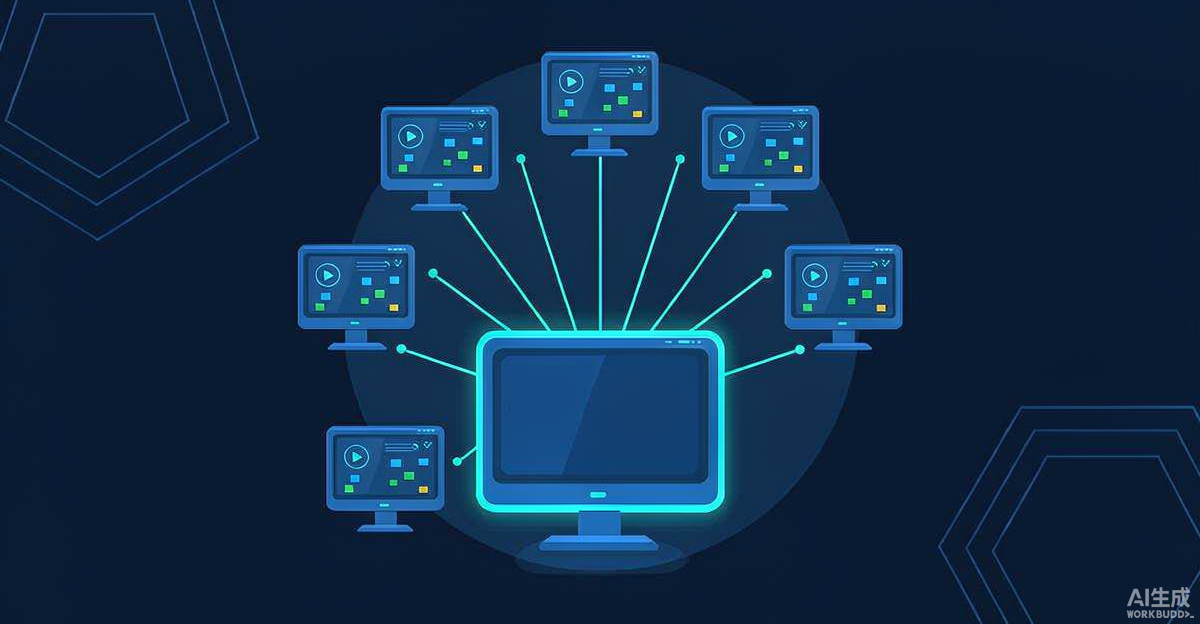
答案藏在「引导节点」里。所谓引导节点,可以理解为一群长期在线、地址相对稳定的志愿者服务器。它们不保存任何种子资源的内容,只做一件事:告诉新来的客户端「附近都有哪些同伴」。客户端第一次启动时,会内置一份这类节点的地址清单,就像一本电话本的第一页。你先拨通这几个号码,问一圈,就能滚雪球般地认识越来越多的节点。整个过程不需要任何一台机器掌握全网,却能让任何一个新节点快速接入。
路由表:把「认识谁」缓存下来
如果每次开机都从零问起,体验会很差。于是客户端会把已经认识的节点信息缓存到本地的「路由表」里。这张表遵循一种叫 Kademlia 的算法组织,每个节点的「距离」用一段哈希值的异或结果来衡量。下次启动时,你优先联系路由表里存着的老朋友,通常几十秒就能重新接入网络。这也解释了为什么第一次安装的客户端往往要「转圈」更久,而老用户几乎秒连——差别就在于路由表有没有积累。
迭代式寻址:一步步逼近目标
光有路由表还不够,磁力链接给出的只是一个「信息指纹」。要找到实际提供数据的同伴,客户端会发起一轮「迭代式问路」:先问已知节点「你认不认识更接近目标的人」,拿到答案后再去问更接近的,如此层层逼近,直到联系上真正持有该种子资源的节点。整个过程像极了「六度分隔」,你并不需要认识所有人,只需要每次问到「更近一步」的人。这也是磁力搜索能脱离单一索引而存在的基础。
为什么这样设计更「抗造」
这套引导机制最大的价值在于去中心化带来的韧性。传统中心服务器一旦宕机或被关闭,所有用户都会失去方向;而磁力链接的世界里,即使一部分引导节点消失,只要还有节点在线,网络就能继续运转。对于合法用途而言,这层韧性尤其可贵:Linux 官方发行版、开源软件镜像、公有领域内容,都可以借助这套机制低成本、高可靠地分发,减轻单一服务器的带宽压力。当然,技术的中立性也意味着它同样可能被用于传播不受版权保护之外的内容,这正是使用者需要自担责任的地方。
磁力搜索引擎又是如何工作的
说到「找到种子资源」,不少人会把引导节点和磁力搜索引擎混为一谈。其实它们分工不同:引导节点负责帮你认识网络里的同伴,而磁力搜索引擎更像一个「检索目录」。后者通过长期抓取网络中的公开索引信息,把大量种子资源的哈希与其名称、大小等元数据关联起来,方便用户按关键词查找。理解这一点很重要:任何一个磁力搜索引擎都不存储内容本身,它索引的只是「哪里可能有人有这份数据」。因此,判断一个磁力搜索引擎是否可信,关键看它是否只做中立索引、是否规范处理侵权通知,以及是否明确引导用户走向正版渠道。对普通用户而言,与其在来路不明的结果里大海捞针,不如优先使用官方开源镜像与正版平台,这些渠道本身就提供了清晰、合法的下载路径。
新手的两个常见误解
第一个误解是「磁力链接里有服务器地址」。实际上,磁力链接本质上只包含一段内容哈希,不指向任何具体机器,地址发现全靠上面这套引导与寻址。第二个误解是「没有 Tracker 就完全连不上」。Tracker 只是早期的集中式索引,如今 DHT 已经让绝大多数场景无需 Tracker 也能正常找到同伴。理解了这两点,你对磁力搜索背后的机制就有了更扎实的认识。
小结
磁力链接的「冷启动」依赖引导节点、路由表缓存与迭代寻址三者的配合,是去中心化网络里一个优雅的解决方案。对普通用户而言,理解原理之余,更重要的是把技术用在正道:通过官方开源镜像站、软件官网获取正版资源,远离来路不明的种子资源,既保护自己,也尊重版权。技术本身没有善恶,决定它走向的,是每一个使用者的选择。
© 版权声明
文章版权归作者所有,未经允许请勿转载。