同一种子,为什么会有几十个「分身」
经常使用磁力搜索的朋友大概都见过这样的现象:同一个文件,在搜索结果里会出现几十条甚至上百条记录,标题、大小、做种数各不相同,让人眼花缭乱。其实这些记录指向的,往往就是同一份内容。有人换了标题,有人改了文件名,还有人顺手把大小信息也改了,但这些改动并不会改变内容本身。那么,磁力搜索引擎是怎么在一片混乱中认出「这几十条其实是同一个东西」的?答案就藏在一串哈希指纹里。
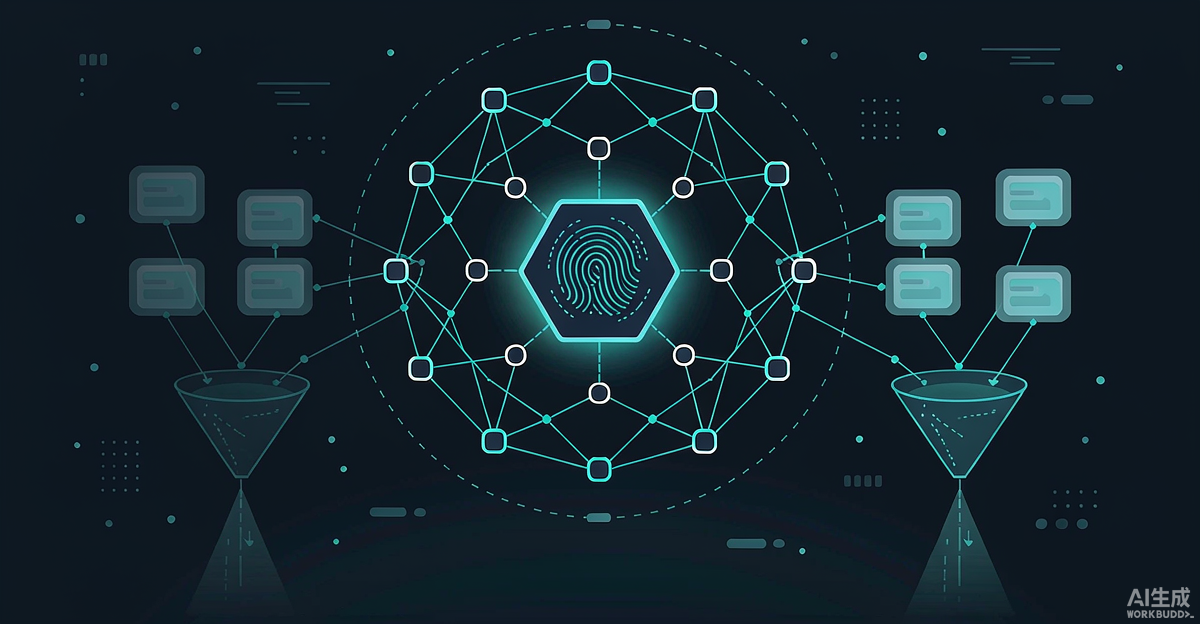
任何一份种子资源,在被制作成 BT 种子时,都会先对核心元数据做一次哈希运算,得到一串固定长度的数字指纹。这串指纹就像内容的「身份证号」,只要内容没有一丝一毫的改动,指纹就完全一致;只要内容改动了哪怕一个字节,指纹就会面目全非。磁力链接本身并不包含文件名、目录结构这些描述性信息,它只带着这串哈希。正因为如此,无论你在标题里写什么、怎么改名,只要哈希相同,搜索引擎就能确定:这些条目指向的是同一份内容。
哈希指纹:磁力链接的「身份证」
要理解去重的原理,得先弄清哈希是什么。哈希算法会把任意长度的输入,压缩成一串固定长度的输出,这个输出就是「哈希值」或「指纹」。BT 协议里,这份指纹正是磁力链接的核心部分,也就是我们常说的 info_hash。它是内容寻址的基石:你不用记住文件叫什么、存在哪台服务器上,只要知道这串哈希,就能在 P2P 网络里找到拥有这份内容的同伴。
这带来一个很有意思的特性:内容相同,哈希必相同;哈希相同,内容也极大概率相同。磁力搜索引擎正是利用了这一点。当它抓取到海量的磁力链接时,会先对每一条做哈希归一化,把同一哈希的记录合并成一条,再在展示时保留做种数最多、来源最可靠的版本。这就是「去重」的底层逻辑。对普通用户来说,去重让搜索结果更清爽,避免了同一份内容刷屏;对搜索引擎本身来说,去重则大大降低了索引存储的开销。
黑名单与污染过滤:搜索结果里的一把筛子
除了去重,成熟的磁力搜索引擎还会维护一张「黑名单」,用来过滤掉已知的有害哈希。这套机制有点像安全软件里的病毒库:当大量用户或监管机构上报某个磁力链接指向的内容有问题——比如捆绑了木马、伪装成正常文件的病毒、或者明显违规的内容——搜索引擎就会把这个哈希加入黑名单,之后这条记录要么被下架,要么被明确标注风险。
不过,哈希黑名单有个天然的局限:哈希是一一对应的,只要内容被稍微改动,哈希就变了,黑名单就认不出它。所以黑名单只能拦住「原封不动」的已知有害内容,对改过头的变体往往无能为力。这也提醒我们,不要以为「能搜到、能去重」就等于「安全」。搜索引擎的过滤是尽力而为的,真正的安全判断,还得靠用户自己:认准官方发布渠道,警惕来路不明的资源。
与去重相对的,还有一种叫「污染」的现象。有人会故意把假的、损坏的、甚至有害的数据,伪装成热门内容,混进 P2P 网络。这些污染数据有的会让下载永远无法完成,有的会夹带恶意程序。对于这类问题,正规客户端会依靠分块哈希校验来识别:每一小块数据都有一个校验值,只要有一块对不上,客户端就会把这块数据丢弃,从别的同伴那里重新获取。这套校验机制,正是 P2P 网络能在「人人不可信」的环境里保持可靠的关键。
去重技术,最终服务的是「内容」而非「版权」
值得强调的是,哈希去重、黑名单、分块校验,这些都是中性的技术,它们服务的是「数据完整性」和「检索效率」,本身并不对内容做价值判断。同样一套去重逻辑,既可以用在开源软件分发上,也可以用在公有领域内容上。比如各大 Linux 发行版通过磁力链接或 BT 分发安装镜像时,哈希校验就保证了用户拿到的是「未经篡改」的官方镜像;互联网档案馆、古登堡计划等机构,也用内容寻址的方式长期保存和分发公有领域资料。
这也引出了我们最想传递的一点:bt磁力、磁力搜索、磁力搜索引擎这些工具,本身是中立的。它们能高效地分发内容,但这个「高效」应该用在合法的地方。当你需要下载操作系统、开源软件、公有领域的书籍或数据集时,官方项目往往直接提供了磁力链接,既快又省服务器带宽,还能通过哈希校验确保文件完整。这比在来路不明的搜索结果里大海捞针,要安全得多。
小结
磁力搜索引擎之所以能在一片「分身」中认出同一种子资源,靠的是哈希指纹的内容寻址能力:同一哈希即同一内容,于是可以合并去重;黑名单和分块校验则像两道筛子,尽力过滤已知有害数据、识别损坏分块。但技术是中性且「尽力而为」的,去重不等于安全,能搜到也不等于合法。真正稳妥的做法,是优先选择官方开源镜像、正版视频与软件平台,以及提供磁力链接的合法机构站点。理解哈希去重的原理,不是为了在灰色地带钻空子,而是为了更清醒、更安全地使用这项技术。
© 版权声明
文章版权归作者所有,未经允许请勿转载。